
AI Bot Trafiği ve Crawl Log Analizi Rehberi
AI botlarını sunucu loglarında ayırt etmeyi, doğru robots.txt kurallarını belirlemeyi ve tarama verisini teknik aksiyonlara dönüştürmeyi öğrenin.
Öne Çıkanlar: AI Bot Trafiği ve Crawl Log Analizi
5- Yapay zekâ şirketleri arama, kullanıcı isteğine bağlı erişim ve model eğitimi için farklı botlar kullanır; hepsine tek robots.txt kuralı uygulamak yanlış sonuç doğurabilir.
- OAI-SearchBot ChatGPT arama görünürlüğüyle, GPTBot ise olası eğitim amaçlı taramayla ilgilidir. İki karar birbirinden bağımsızdır.
- Sunucu logları istenen URL’yi, yanıt kodunu ve tarama sıklığını gösterir; ancak user-agent bilgisi doğrulanmadan ziyaret meşru bot trafiği sayılmamalıdır.
- robots.txt gizlilik veya kesin indeks kaldırma aracı değildir. Özel içerikler için kimlik doğrulama ve erişim kontrolü gerekir.
- Log analizinin faydalı çıktısı; engellenen açık sayfaları, tekrar eden hataları, render sorunlarını ve boşa harcanan taramayı önceliklendiren bir aksiyon listesidir.
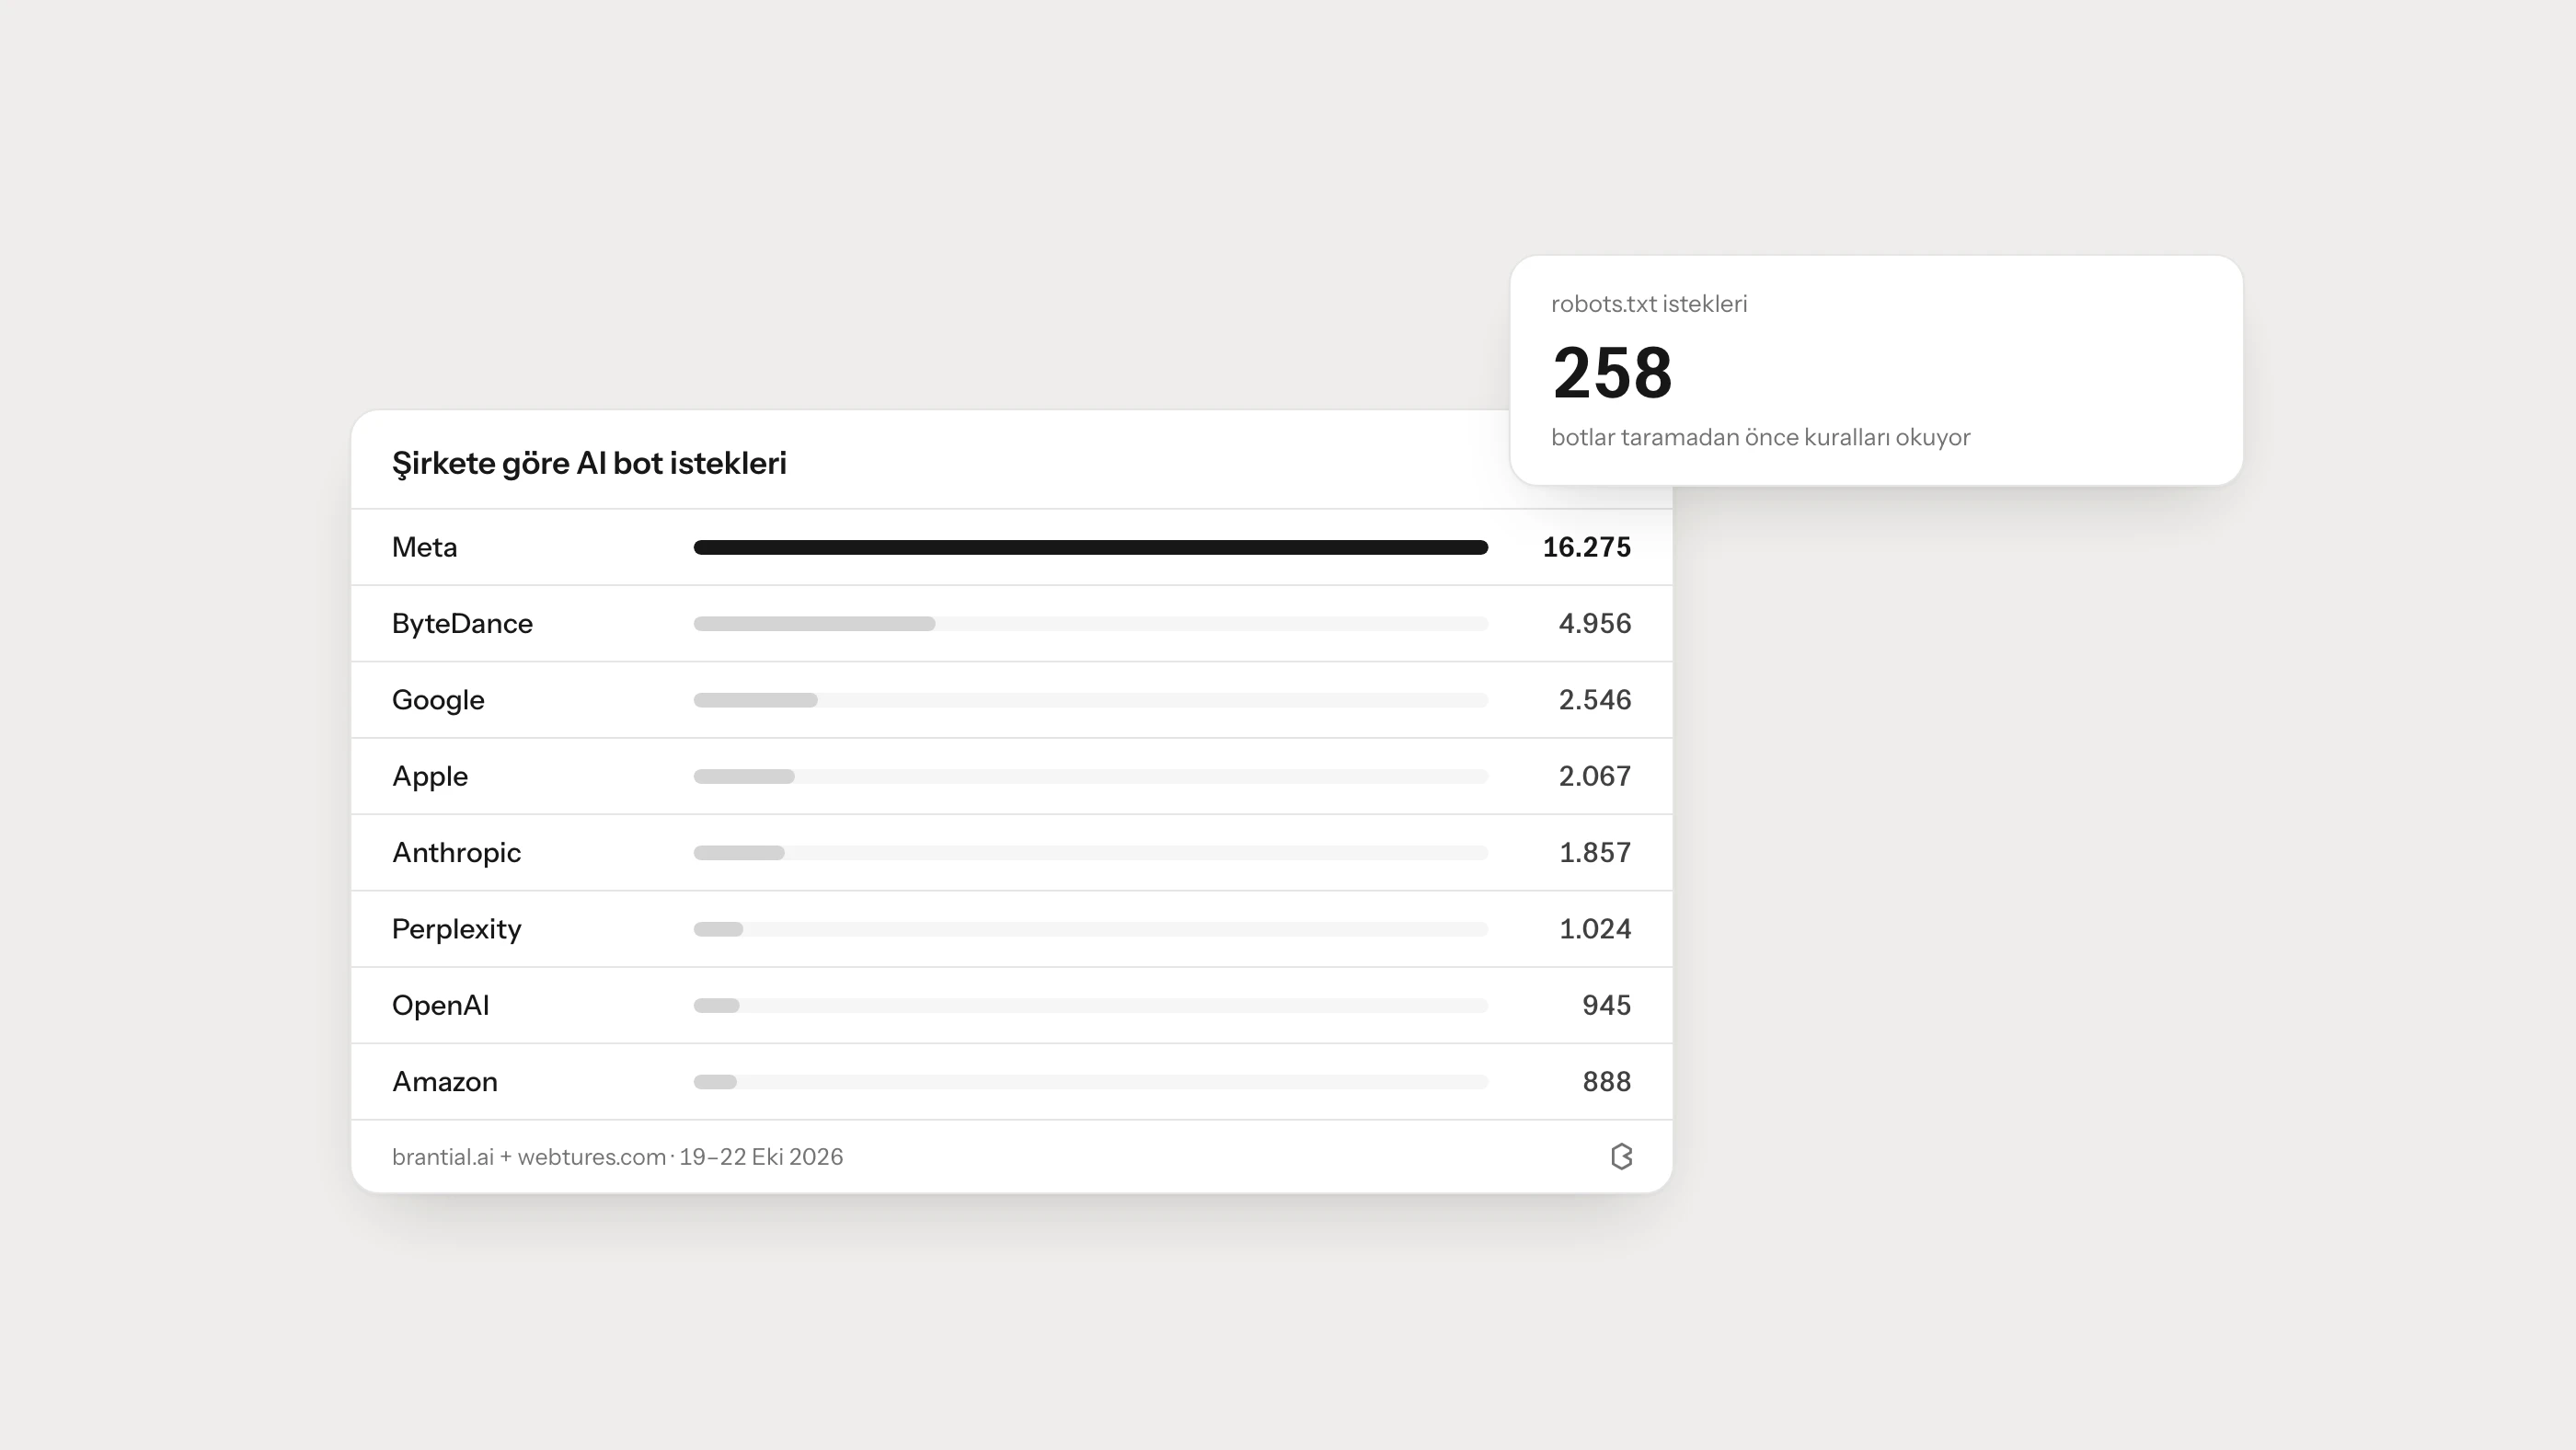
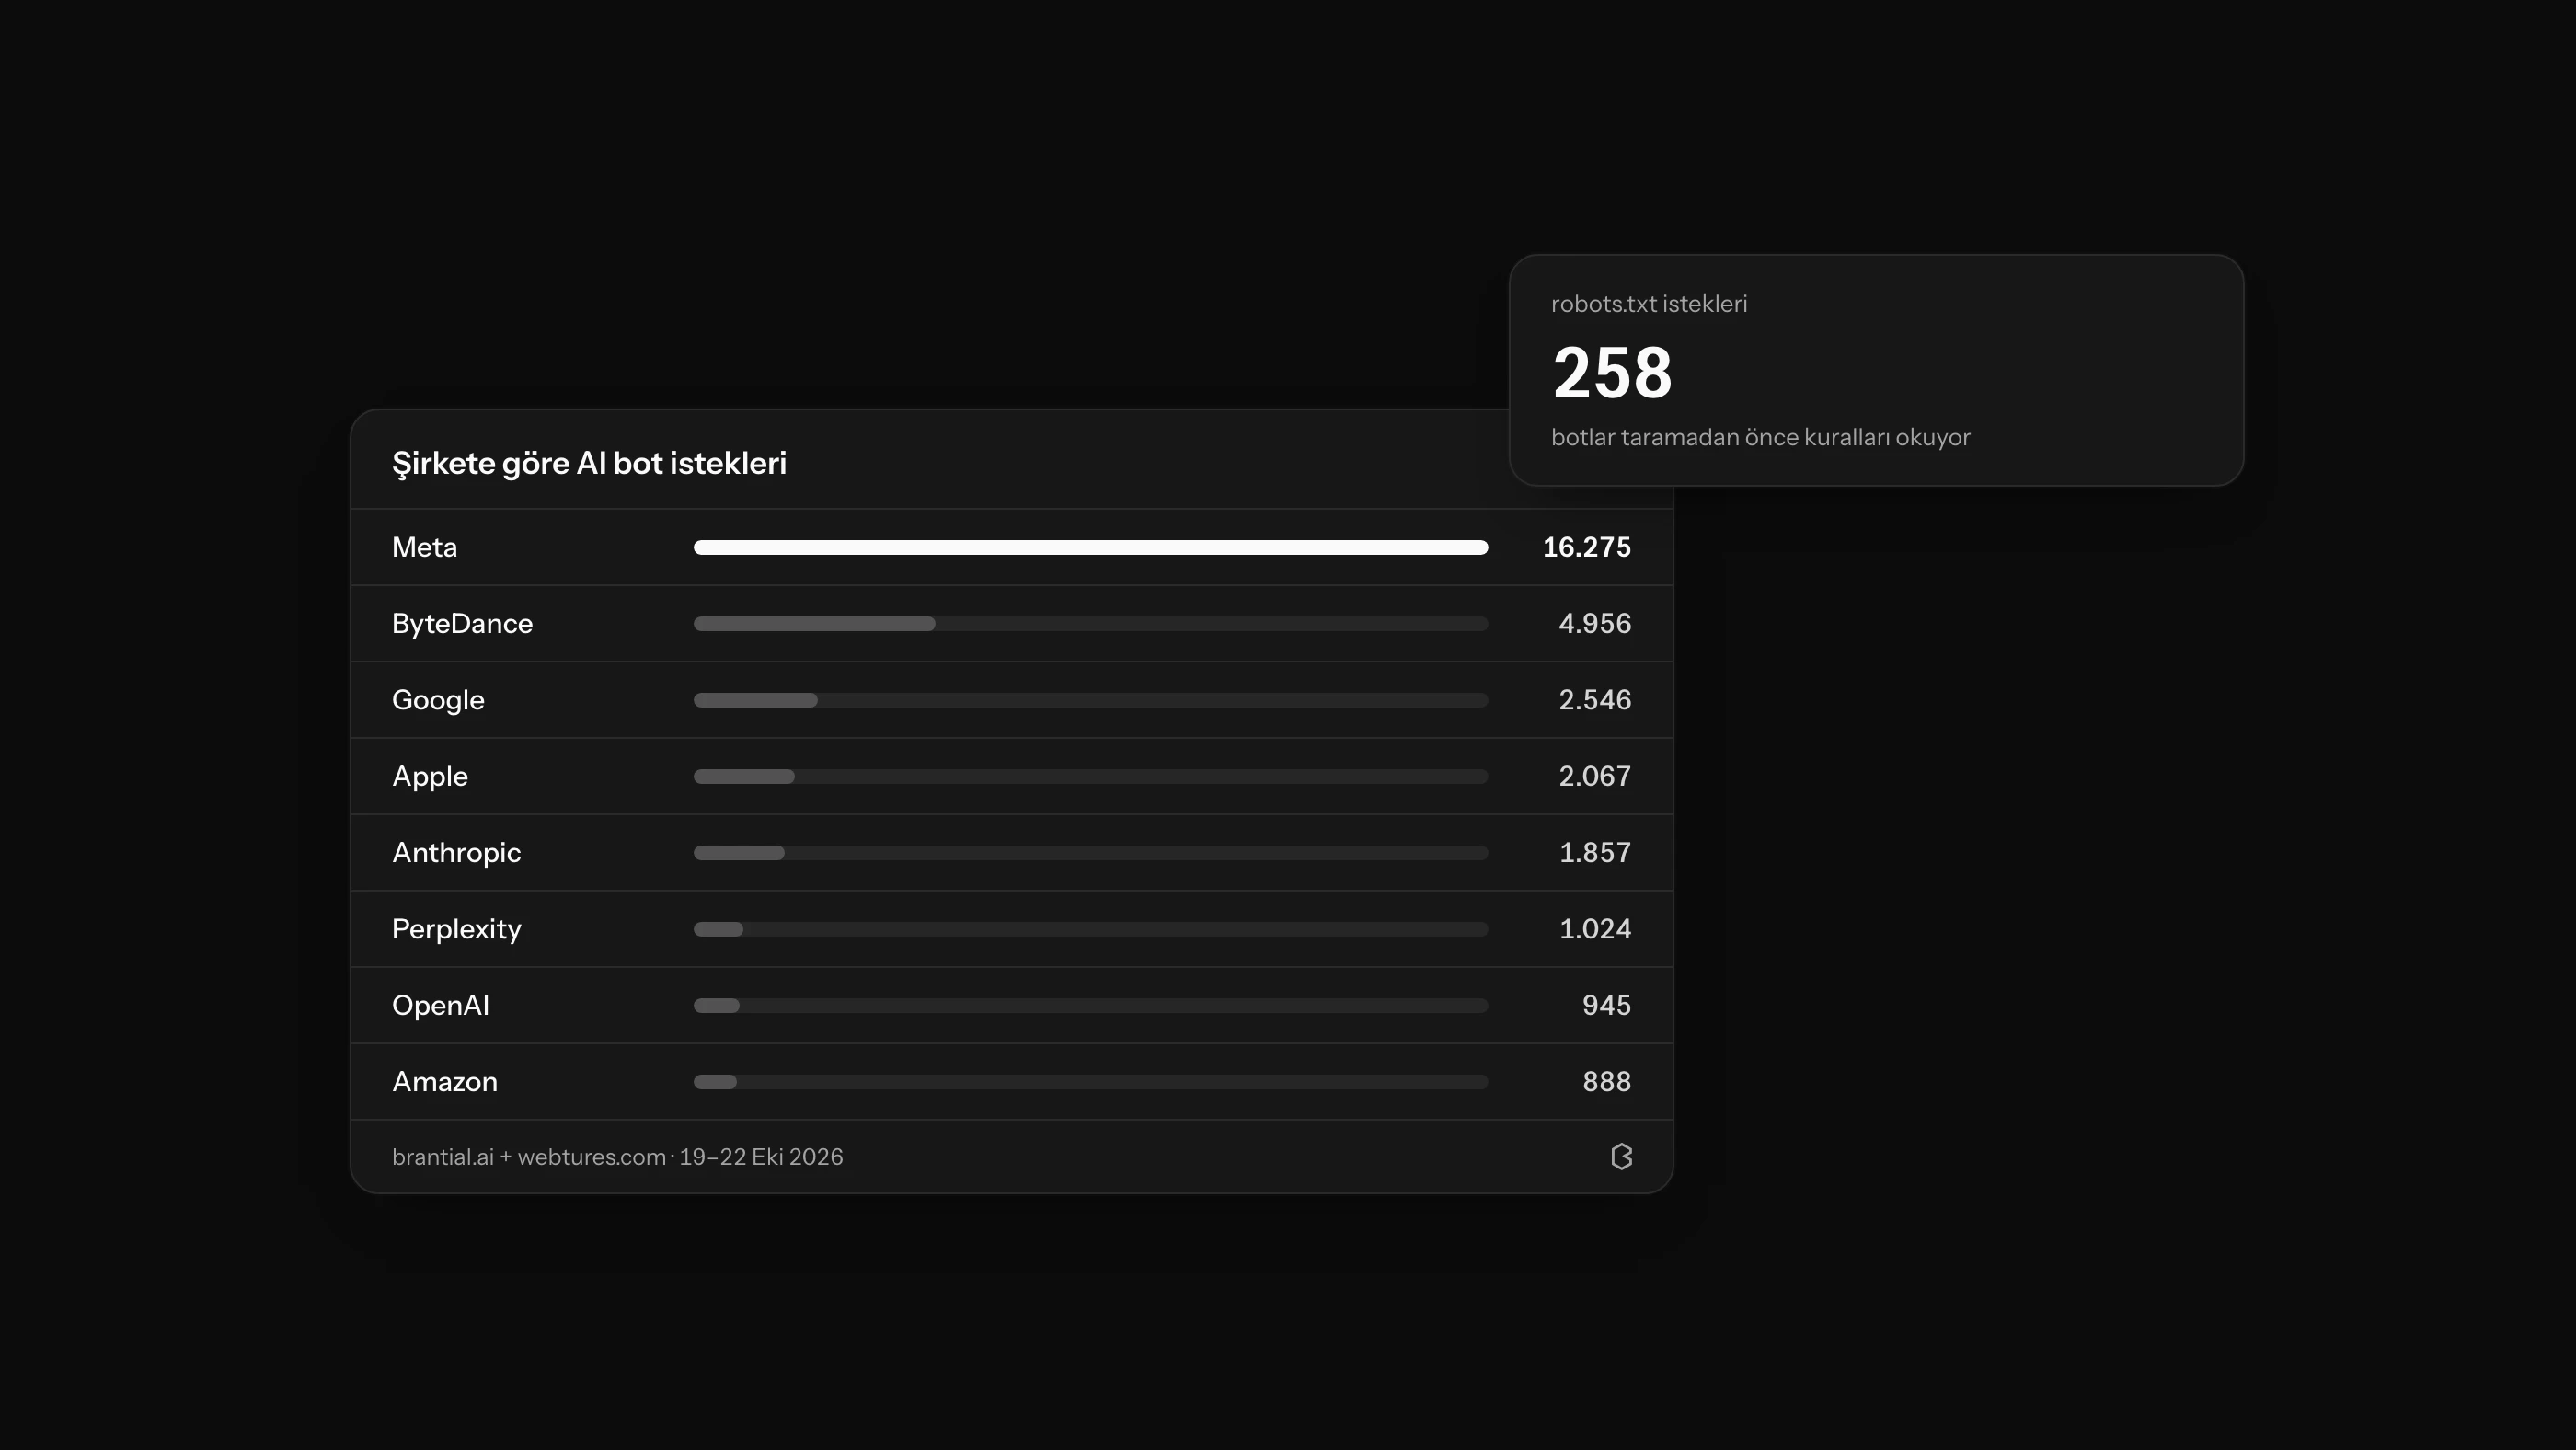
AI bot trafiği analizi şu soruyla başlar: Hangi otomatik sistem hangi sayfayı istedi ve karşılığında ne gördü? Sunucu logları; istenen URL, zaman, user-agent, yanıt kodu ve çoğu zaman kaynak IP gibi bilgileri tutar. Üstelik JavaScript analitik kodunu hiç çalıştırmayan ziyaretleri de gösterir.
Asıl mesele veriyi doğru yorumlamaktır. Örneğin OAI-SearchBot, GPTBot ve ChatGPT-User aynı işi yapmaz. Tüm AI user-agent’larını tek bot gibi değerlendirmek, yalnızca eğitim amaçlı taramayı kapatmaya çalışırken arama görünürlüğünü de engellemenize yol açabilir.
Hangi AI Botu Ne İşe Yarar?
Bot adları ve politikaları değişebildiği için güncel kararı her zaman sağlayıcının kendi dokümanına göre verin. Aşağıdaki tablo uygulamaya dönük bir başlangıç noktasıdır; kalıcı bir bot sicili değildir.
| User-agent | Açıklanan amacı | Uygulamadaki karşılığı |
|---|---|---|
OAI-SearchBot | ChatGPT aramasında içerik keşfi ve bağlantı gösterimi | Sayfalarınızın ChatGPT aramasına uygun olmasını istiyorsanız izin verin |
GPTBot | OpenAI modellerinin geliştirilmesinde kullanılabilecek içerikleri tarama | Eğitim politikanıza göre ayrı karar verin; arama görünürlüğüyle aynı ayar değildir |
ChatGPT-User | Kullanıcı eylemi üzerine belirli bir sayfayı getirme | Site geneli taramadan ayrı, istek üzerine erişim olarak analiz edin |
Claude-SearchBot | Arama sonucu kalitesi ve görünürlük | Claude arama keşfi önemliyse izin politikasını buna göre belirleyin |
ClaudeBot | Model geliştirmede kullanılabilecek içeriği tarama | Eğitim politikanızı bağımsız uygulayın |
Claude-User | Kullanıcının istediği sayfaya erişme | Olağan crawler trafiğinden ayrı değerlendirin |
PerplexityBot | Perplexity aramasında web sitelerini bulma ve kaynak gösterme | Açık sayfaların keşfedilmesini istiyorsanız erişimi doğrulayın |
OpenAI bu ayrımı Yayıncılar ve Geliştiriciler SSS sayfasında açıklıyor. Anthropic; ClaudeBot, Claude-SearchBot ve Claude-User için ayrı açıklamaları web crawler dokümanında yayımlıyor. Perplexity’nin bot amacı ve doğrulama bilgileri resmî crawler dokümanında bulunuyor.
OAI-SearchBot Nedir?
OAI-SearchBot, OpenAI’ın arama crawler’ıdır. OpenAI, içeriğinin ChatGPT arama sonuçlarında yer almaya uygun olmasını isteyen sitelerin bu bota izin vermesi gerektiğini belirtiyor. Uygun olmak, kaynak gösterileceğiniz veya belirli bir sırada çıkacağınız anlamına gelmez; sayfanın erişilebilir, ilgili ve faydalı olması da gerekir.
Önemli ayrım şudur: GPTBotu engellemek, OAI-SearchBotu da engellemenizi gerektirmez. Bir yayıncı olası eğitim amaçlı taramayı kapatırken arama keşfine izin verebilir. Ayrıca robots.txt izin verse bile sunucu, CDN veya WAF katmanındaki bir engel erişimi kesebilir.
Uygulanabilir robots.txt Karar Tablosu
Kural yazmadan önce ulaşmak istediğiniz sonucu netleştirin.
| Hedef | Uygun işlem | Sık yapılan hata |
|---|---|---|
| ChatGPT aramasında uygun olmak | OAI-SearchBota izin verin; CDN/WAF erişimini de kontrol edin | robots.txt izin verirken edge katmanında IP’leri engellemek |
| OpenAI eğitim taramasını kapatmak | GPTBotu engelleyin | Arama keşfi dâhil tüm OpenAI botlarını kapatmak |
| Claude arama keşfini desteklemek | Claude-SearchBota izin verin | ClaudeBot ile Claude-SearchBotun aynı amaçta olduğunu varsaymak |
| Özel içeriği korumak | Kimlik doğrulama ve yetkilendirme uygulayın | robots.txt dosyasını güvenlik duvarı sanmak |
| Açık bir sayfayı indeksten kaldırmak | Uygun noindex veya kaldırma sürecini kullanın ve botun etiketi görebilmesini sağlayın | Bot noindexi okuyamadan taramayı engellemek |
| Gereksiz yükü azaltmak | Düşük değerli yolları sınırlandırın, kötüye kullanımı kontrollü şekilde yavaşlatın | Değerli açık içeriği site genelinde kapatmak |
ChatGPT arama keşfine açık kalmak, ancak GPTBot eğitim taramasını kapatmak isteyen bir yayıncı şu kuralları kullanabilir:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Dosyanın /robots.txt adresinde başarılı yanıt verdiğini ve yayından sonra gerçekten güncellendiğini kontrol edin. Google’ın robots.txt açıklaması bu dosyanın sınırını net biçimde anlatır: robots.txt taramayı yönetir, gizlilik sağlamaz; dış bağlantılardan bilinen engelli bir URL yine de arama sistemlerince bilinebilir.
Sunucu Loglarında Hangi Alanlar Tutulmalı?
Analiz için en az şu alanları saklayın:
- zaman damgası ve saat dilimi,
- istenen yol ve sorgu parametreleri,
- HTTP metodu ve yanıt kodu,
- user-agent ve kaynak IP,
- yanıt boyutu ve istek süresi,
- varsa referrer bilgisi.
Gruplama yapmadan önce URL’leri normalize edin. Aksi hâlde /rehber, /rehber/ ve takip parametreli sürümler üç ayrı sayfa gibi görünebilir. Bir kalıbı araştırmanız gerektiğinde tekil isteğe dönebilmek için ham veriyi de koruyun.
AI Botunun Gerçek Olduğu Nasıl Doğrulanır?
User-agent bir iddiadır, kanıt değildir. Herhangi bir script kendini GPTBot veya PerplexityBot olarak tanıtabilir.
Doğrulamayı sağlayıcının yayımladığı yönteme göre yapın. Bu yöntem; yayımlanmış IP aralıklarıyla eşleştirme, ileri ve ters DNS kontrolü veya edge sağlayıcısının doğrulanmış bot sınıflandırması olabilir. Cloudflare farklı yöntemleri Verified Bots dokümanında açıklıyor.
Yalnızca adı güvenilir göründüğü için doğrulanmamış bir isteğe kalıcı izin vermeyin. Kaynağı netleşene kadar bu trafiği ayrı bir grupta tutun.
AI Crawler Log Analizi Nasıl Yapılır?
Önce yedi günlük bir örneklem alın; trafik azsa dönemi genişletin.
- Botun amacını sınıflandırın. Arama crawler’larını, eğitim botlarını, kullanıcı isteğiyle çalışan fetcher’ları ve bilinmeyenleri ayırın.
- Kaynağı doğrulayın. Varsa sağlayıcının yayımladığı doğrulama yöntemini uygulayın.
- Yanıt kodlarına göre gruplayın. İstek sayısına bakmadan önce
401,403,404,429ve5xxyanıtlarını inceleyin. - Sayfa tiplerini karşılaştırın. URL’leri tek tek okumak yerine ürün, kategori, dokümantasyon, blog ve hukuki şablonları ayırın.
- Değerli ama ziyaret almayan sayfaları bulun. İç bağlantı, sitemap veya erişim izni eksik olabilir.
- Tekrarlanan düşük değerli istekleri inceleyin. Filtre URL’leri, takvimler ve parametre döngüleri fayda üretmeden tarama yükü yaratabilir.
- Bulguyu sorumlu ve tarihle eşleştirin. “İsteklerin %43’ü 403” yalnızca belirtidir; “edge kuralı üç açık ürün şablonunu engelliyor” uygulanabilir bir iştir.
Veriyi Yanlış Yorumlamamak İçin
Daha fazla bot trafiği her zaman daha iyi değildir. Ani artış, tekrar eden hata veya bozuk URL kalıbından kaynaklanabilir. Düşük trafik de tek başına ceza işareti sayılmaz; kullanıcı isteğiyle çalışan fetcher’lar yalnızca belirli bir sayfa çağrıldığında görünebilir.
Tarama verisini şu kontrollerle birlikte okuyun:
- Sayfa XML sitemap’te ve iç navigasyonda bulunuyor mu?
- URL giriş veya ülkeye özel doğrulama olmadan
200dönüyor mu? - Ana yanıt ilk HTML’de veya render edilen HTML’de görülebiliyor mu?
- Canonical ve dil etiketleri tutarlı mı?
- Önemli prompt kümesinde AI yanıtları sayfayı kaynak gösteriyor mu?
- OpenAI’ın belirttiği
utm_source=chatgpt.comgibi tanınabilir bir kaynakla insan yönlendirmesi geliyor mu?
Crawler erişimi bazı keşif yolları için ön koşuldur; tek başına görünürlük puanı değildir.
AI Tarama Denetimlerinde Sık Bulunan Sorunlar
En faydalı denetimler çoğu zaman bildik teknik hataların yeni sonuçlarını ortaya çıkarır:
- WAF kuralı scraper’larla birlikte doğrulanmış botları da engeller,
- açık dokümantasyon ana pazar dışındaki isteklerde
403döner, - istemci tarafında render edilen sayfa ham HTML’de yalnızca boş uygulama kabuğu gösterir,
- canonical etiketleri filtreli sayfaları yanlış kategoriye yönlendirir,
- iç bağlantılar taranabilir
hrefyerine JavaScript kontrolü olarak kurulmuştur, - sitemap’teki eski URL’ler yönlendirme veya
404döner, - robots.txt ana içeriği render etmek için gereken kaynakları kapatır,
- rate limit kuralları meşru botlara sürekli
429verir.
Sorun render ise AI Botları JavaScript Siteleri Okuyabilir mi? rehberine bakın. Daha geniş teknik kontrol için AI Site Denetimi Kontrol Listesi ile ilerleyebilir veya Brantial Site Health üzerinden siteyi inceleyebilirsiniz.
Sık Sorulan Sorular
OAI-SearchBot’a izin vermek ChatGPT’de kaynak gösterilmeyi garanti eder mi?
Hayır. İçeriği ChatGPT araması için keşfedilebilir hâle getirir; seçilme, kaynak gösterilme veya sıralama garantisi vermez.
robots.txt gizli içeriği korur mu?
Hayır. Gizli veya ücretli içeriği kimlik doğrulama ve yetkilendirmeyle koruyun. robots.txt herkesin okuyabildiği bir crawler talimat dosyasıdır.
Tüm AI botlarına izin vermek gerekir mi?
Tek bir doğru yoktur. Arama keşfi, kullanıcı isteğine bağlı erişim ve eğitim erişimini ayrı ayrı değerlendirin; kararı hukuk, güvenlik ve içerik ekipleriyle belgeleyin.
GA4, sunucu log analizinin yerini tutar mı?
Hayır. Birçok bot JavaScript analitik kodunu çalıştırmaz. GA4 insan yönlendirme oturumlarını; sunucu veya edge logları ise crawler isteklerini anlamak için daha uygundur.
Bot politikası ne sıklıkla gözden geçirilmeli?
Sağlayıcı dokümanı veya site erişim kuralları değiştiğinde ve teknik arama bakımının bir parçası olarak en az üç ayda bir kontrol edilmelidir.