
Arama Botu Nedir? 2026 Arama Motoru ve AI Botları Listesi
Arama botu, sayfalarınızı arama motorları ve AI asistanları için ziyaret eder. 2026’da hangi botun ne yaptığını ve robots.txt’te hangisine izin vermeli?
Öne Çıkanlar
5- Arama botu, web sayfalarını bir arama motorunun ya da AI asistanının bulup okuyabilmesi için ziyaret eden programdır. En bilinen örnekler Googlebot ve Bingbot.
- AI şirketleri farklı işler için farklı botlar kullanıyor: biri arama için, biri model eğitimi için, biri de kullanıcı istediğinde sayfayı açmak için. Her biri için robots.txt’te ayrı karar vermek gerekiyor.
- Bir arama botunu engellerseniz o ürünün cevaplarından çıkarsınız. Eğitim botunu engellemek bunu yapmaz. En sık yapılan hata ikisini karıştırmak.
- Google-Extended ve Applebot-Extended aslında bot değil. AI eğitimini kontrol eden robots.txt adları; arama sonuçlarını etkilemiyorlar.
- User-agent taklit edilebilir. Google, OpenAI, Anthropic, Perplexity, Apple ve diğerleri, bir ziyaretin gerçek olup olmadığını kontrol edebilmeniz için IP aralıklarını yayınlıyor.
Arama botu (crawler ya da spider da deniyor), web sayfalarını otomatik olarak ziyaret eden ve bir arama motorunun ya da AI asistanının bu sayfaları bulup okuyabilmesini, insanlara gösterebilmesini sağlayan programdır. Google sayfanızı sonuçlarda gösterdiğinde ya da ChatGPT bir cevapta sizi kaynak gösterdiğinde, o sayfayı önce bir bot çekmiştir.
Yıllarca “arama botu” deyince akla Googlebot ve Bingbot gelirdi. 2026’da liste çok daha uzun. OpenAI, Anthropic, Perplexity, Apple, Meta ve Amazon’un hepsi kendi botlarını gönderiyor, çoğu da birden fazla. Hangisinin ne olduğunu bilmek, sayfalarınızın AI cevaplarında çıkıp çıkmayacağını belirliyor.
Arama botu nasıl çalışır?
Bir arama botu aynı üç işi sürekli tekrarlar.
- Keşfeder. Linklerden, site haritalarından ve daha önce gördüğü sayfalardan yeni adresler bulur.
- Çeker. Sayfayı tıpkı bir tarayıcı gibi sunucunuzdan ister ve user-agent başlığında kendini bir isimle tanıtır.
- Teslim eder. Bulduğunu arkasındaki sisteme verir. Bu, bir arama motoru için dizindir. Bir AI asistanı içinse bir arama dizini, bir eğitim veri seti ya da o anda birinin beklediği tek bir cevap olabilir.
Kurallara uyan botlar, sayfayı çekmeden önce robots.txt dosyanızı okur ve girmemesini istediğiniz yerlere girmez. Botlara nereye girip giremeyeceklerini söylemenin ana yolu bu dosyadır.
Bir siteyi ne tür botlar ziyaret eder?
Her bot aynı işi yapmaz; bu, üzerindeki şirket adından daha önemlidir.
| Tür | Ne yapar | Örnek |
|---|---|---|
| Arama motoru botu | Arama motorunun dizinini oluşturur | Googlebot, bingbot |
| AI arama botu | AI asistanının cevaplarda kaynak gösterebileceği sayfaları bulur | OAI-SearchBot, Claude-SearchBot, PerplexityBot |
| Eğitim botu | AI modellerini eğitmekte kullanılabilecek sayfaları toplar | GPTBot, ClaudeBot, CCBot |
| Kullanıcı tetiklemeli bot | Kullanıcı asistandan istediği için bir sayfayı açar | ChatGPT-User, Claude-User, Perplexity-User |
| Kontrol adı | Bot değil; AI eğitiminden çıkmak için robots.txt’te kullanılan bir ad | Google-Extended, Applebot-Extended |
İşin pratik özeti şu: bir AI arama botunu engellemek sizi o asistanın cevaplarından çıkarır; eğitim botunu engellemek çıkarmaz. Bunlar ayrı kararlar.
Arama motoru botları
Klasik arama sonuçlarının arkasındaki botlar bunlar. Google ve Microsoft’ta AI cevaplarının arkasında da bu botlar var.
| User-agent | Şirket | Ne için |
|---|---|---|
Googlebot | AI Overviews ve AI Mode dahil Google Arama, Discover, Görseller ve Haberler | |
bingbot | Microsoft | Bing arama. Copilot da aynı tarama ve dizini kullanıyor |
Applebot | Apple | Spotlight, Siri ve Safari önerileri |
DuckDuckBot | DuckDuckGo | DuckDuckGo arama sonuçları |
YandexBot | Yandex | Yandex arama dizini |
Google, AI Overviews ve AI Mode’un da Arama’nın geri kalanıyla aynı Googlebot taramasını kullandığını söylüyor; yani bunlar için ayrıca izin vermeniz gereken bir bot yok. Google Search Central: AI özellikleri. Microsoft da Bing ve Copilot’un aynı tarama, dizin ve sıralama altyapısını paylaştığını belirtiyor. Bing Webmaster Yönergeleri.
AI botları: 2026 listesi
Aşağıdaki şirketlerin hepsi botlarını resmi bir sayfada anlatıyor; son sütunda linkleri var. Bot adları ve kurallar değişebiliyor, bu yüzden güncel bilgi için o sayfaları esas alın.
| User-agent | Şirket | Görevi | robots.txt’e uyuyor mu | Kaynak |
|---|---|---|---|---|
OAI-SearchBot | OpenAI | ChatGPT aramada gösterilecek sayfaları bulur; eğitimde kullanılmaz | Evet | OpenAI |
GPTBot | OpenAI | OpenAI modellerini eğitmek için içerik toplar | Evet | OpenAI |
ChatGPT-User | OpenAI | Bir ChatGPT kullanıcısı ya da GPT istediğinde sayfayı açar | Her zaman değil | OpenAI |
Claude-SearchBot | Anthropic | Claude’un arama dizini | Evet | Anthropic |
ClaudeBot | Anthropic | Model eğitimi için içerik toplar | Evet | Anthropic |
Claude-User | Anthropic | Claude kullanıcısının istediği sayfayı çeker | robots.txt ile kontrol edilebilir | Anthropic |
PerplexityBot | Perplexity | Perplexity’de gösterilecek ve linklenecek sayfaları bulur; eğitimde kullanılmaz | Evet | Perplexity |
Perplexity-User | Perplexity | Kullanıcının sorduğu sayfayı çeker | Genellikle hayır | Perplexity |
Google-Extended | Bot değil, kontrol adı: Gemini eğitimi ve grounding’den çıkarır; Arama’yı etkilemez | – | ||
Applebot-Extended | Apple | Bot değil, kontrol adı: Apple’ın AI eğitiminden çıkarır; aramayı etkilemez | – | Apple |
meta-externalagent | Meta | Meta’nın AI ürünleri için eğitim ve dizinleme | Evet | Meta |
meta-externalfetcher | Meta | Bir kullanıcı ya da ajan görevi için sayfa çeker | Her zaman değil | Meta |
Amazonbot | Amazon | Amazon ürün ve hizmetleri; Amazon’un AI modellerini eğitmekte de kullanılabilir | Evet | Amazon |
Amzn-SearchBot | Amazon | Alexa gibi arama deneyimleri; eğitimde kullanılmaz | Evet | Amazon |
DuckAssistBot | DuckDuckGo | Kaynaklı AI cevapları için sayfa çeker; eğitimde kullanılmaz | Evet | DuckDuckGo |
CCBot | Common Crawl | Pek çok AI modelinin eğitildiği açık Common Crawl veri setini oluşturur | Evet | Common Crawl |
Bu tabloda iki şey çoğu kişiyi şaşırtıyor. Birincisi, ChatGPT-User ve Perplexity-User gibi kullanıcı tetiklemeli botlar robots.txt’e her zaman uymayabiliyor; şirketler bunları bir linke tıklayan insan gibi değerlendiriyor. İkincisi, Google-Extended ve Applebot-Extended sitenizi hiç ziyaret etmiyor. Bunlar robots.txt’e yazdığınız adlar; onları normal Googlebot ve Applebot okuyor.
Loglarınızda ByteDance’e ait olduğu söylenen Bytespider’ı da görebilirsiniz. ByteDance’in bu botu anlatan resmi bir sayfasını bulamadığımız için tabloya almadık.
Gelen bot gerçekten iddia ettiği bot mu?
Bir user-agent başlığına herkes “Googlebot” yazabilir; içerik kazıyan botlar bunu sürekli yapar. Bir ziyarete güvenmeden ya da onu engellemeden önce nereden geldiğine bakın.
- Yayınlanan IP listeleri. Google, OpenAI, Anthropic, Perplexity, Apple, Common Crawl, Amazon ve DuckDuckGo botlarının kullandığı IP aralıklarını yayınlıyor. Google, kendi isteklerini nasıl doğrulayacağınızı Googlebot ve diğer Google tarayıcılarını doğrulama sayfasında anlatıyor.
- Ters DNS sorgusu. Bing ve Yandex, ziyaret eden IP için ters DNS sorgusu yapıp çıkan alan adının kendilerine ait olduğunu kontrol etmenizi istiyor.
Kendini GPTBot olarak tanıtıp OpenAI’ın listesi dışındaki bir IP’den gelen istek GPTBot değildir.
Hangi arama botlarına izin vermelisiniz?
Herkes için tek bir doğru cevap yok. Ama bulunmak isteyen çoğu marka için mantıklı bir başlangıç var.
- Arama botlarına izin verin, hem klasik hem AI:
Googlebot,bingbot,OAI-SearchBot,Claude-SearchBot,PerplexityBot,Applebot. Bunları engellemek sizi sonuçlardan ve AI cevaplarından çıkarır. - Eğitim konusuna ayrı karar verin.
GPTBot,ClaudeBot,CCBot,Google-ExtendedveApplebot-Extendedmodel eğitimiyle ilgili; bugün cevaplarda görünüp görünmeyeceğinizle değil. - Bilmediğiniz şeyi engellemeyin. Adında “AI” ya da “GPT” geçen her botu engelleyen toplu bir kural, korumak istediğiniz arama botlarını da genellikle dışarıda bırakır.
AI aramayı açık tutup eğitimden çıkan bir robots.txt şöyle görünebilir:
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: CCBot
Disallow: /
Bu bir örnek; her site için öneri değil. Pek çok marka, modeller kendisini daha iyi tanısın diye içeriğinin eğitim verisinde olmasını istiyor. Değişikliklerin oturması da zaman alıyor: OpenAI’a göre bir robots.txt değişikliğinin uygulanması yaklaşık bir gün sürebiliyor.
robots.txt bir kilit değil, bir rica. Kurallara uyan botları bir sayfadan uzak tutar ama sayfayı gizlemez. Gizli kalması gereken içerik için hâlâ giriş (login) gerekir.
Sitenizi hangi botların ziyaret ettiğini nasıl görürsünüz?
Sunucu ya da CDN loglarınız her isteği user-agent’ı, adresi ve durum koduyla kaydeder. Bunları yukarıdaki adlara göre filtrelerseniz hangi botların geldiğini, ne sıklıkla geldiğini ve hangi sayfaların onlara hata döndürdüğünü görürsünüz. Bunu adım adım AI bot trafiği ve log analizi rehberimizde anlattık.
Sorunların çoğunu iki hızlı kontrol yakalar:
- Bir arama botunu yanlışlıkla engelliyor musunuz? robots.txt dosyanızı yukarıdaki tabloyla yan yana okuyun.
- Botlar içeriği okuyabiliyor mu? Ana metin ancak JavaScript çalıştıktan sonra görünüyorsa, bazı AI botları boş bir sayfa görür. Ayrıntısı AI botları JavaScript siteleri okuyabilir mi yazımızda.
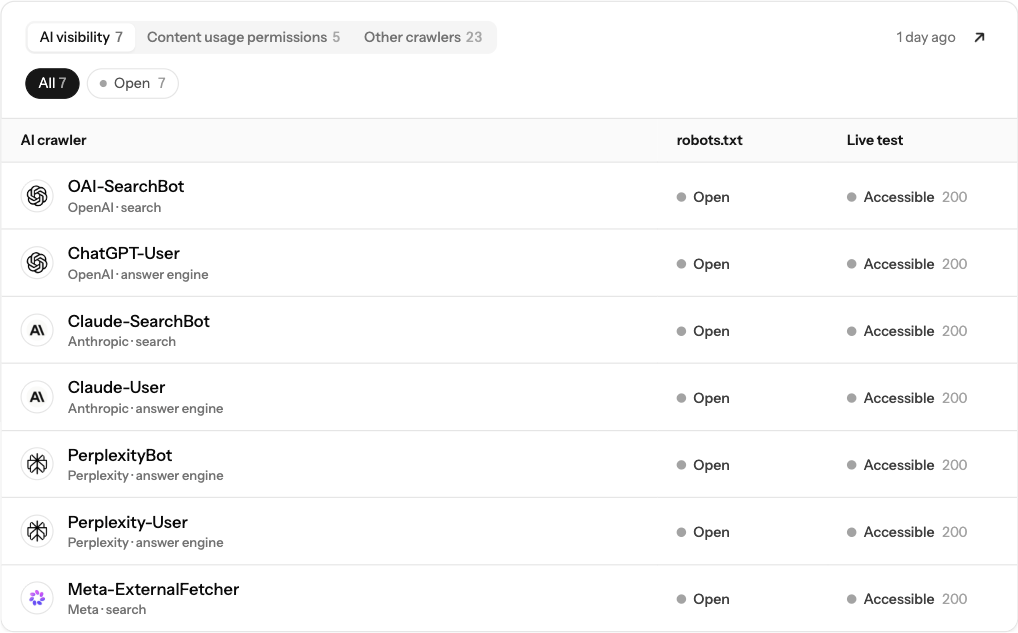
Brantial’ın Site Sağlığı ekranında bu kontrol, Brantial’ı geliştiren şirketin sitesi webtures.com için şöyle görünüyor: tüm AI arama botlarına robots.txt’te izin verilmiş ve canlı testte hepsi normal bir sayfa (HTTP 200) alıyor.
Taranmak sadece ilk adım. Bot sayfanızı aldıktan sonra bir AI cevabının onu seçmesi gerekiyor; o kısmı RAG nedir yazımızda anlattık.
Sık sorulan sorular
Arama botu ile crawler arasındaki fark nedir?
Günlük kullanımda fark yok; aynı şeyi anlatıyorlar. “Crawler” ve “spider” programın linkten linke nasıl gezindiğini, “arama botu” ise ne işe yaradığını anlatıyor.
AI Overviews için Googlebot mu kullanılıyor?
Evet. Google, AI Overviews ve AI Mode’un Arama’nın geri kalanıyla aynı Googlebot taramasına dayandığını söylüyor. İzin vermeniz gereken ayrı bir bot yok; dizinde olmak ve snippet ile gösterilebilir olmak dışında ek bir teknik şart da yok.
GPTBot’u engellersem sitem ChatGPT’den çıkar mı?
Hayır. GPTBot, OpenAI’ın eğitim botu. ChatGPT arama ise OAI-SearchBot kullanıyor. ChatGPT aramada çıkmaya devam etmek için OAI-SearchBot’a izin verin; GPTBot’u engellemek sadece olası eğitim kullanımını etkiler.
Google-Extended nedir?
Bir bot değil, robots.txt’te kullanılan bir kontrol adı. Engellediğinizde Google’a içeriğinizi Gemini modellerini eğitmek ve Gemini uygulamaları ile Vertex AI’da grounding için kullanmamasını söylersiniz. Sitenizin Google Arama’da nasıl göründüğünü değiştirmez.
AI botları robots.txt’e uyuyor mu?
Şirketlerinin açıklamasına göre arama ve eğitim botlarının çoğu uyuyor. Kullanıcı istediği için sayfa açan kullanıcı tetiklemeli botlar ise uymayabiliyor. İlgili botun sağlayıcısının dokümanına bakın.